技术 / 全文阅读
智元发布GO-3 Preview具身基础模型,称在RoboDojo、RoboTwin、RoboColiseum三项基准居首
AGIBOT unveils GO-3 Preview and takes top spot on three embodied AI benchmarks
AI 导读 · 根据来源整理
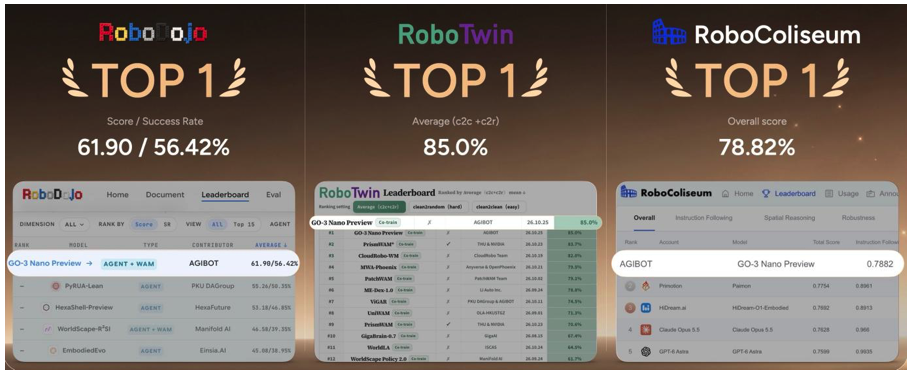
智元发布具身基础模型GO-3 Preview,称其在RoboDojo、RoboTwin、RoboColiseum三项具身智能基准上排名第一,并计划于2026年底完全开源。
这款全新的具身基础模型打通了预训练、后训练与部署后学习,帮助机器人形成通用能力,并在真实世界经验中持续提升
AGIBOT 发布了 GO-3 Preview,这是一款具身基础模型,支持在预训练、后训练和部署后全生命周期内进行大规模学习。
该模型还在 RoboDojo、RoboTwin 和 RoboColiseum 三大具身 AI 基准测试中位列第一,并将在 2026 年底前全面开源。
GO-3 Preview 基于 AGIBOT 自研的具身原生架构 WRAM(World Reasoning Action Model,世界推理动作模型)构建,统一了任务理解、未来状态预测和动作生成,使机器人能够跨任务泛化并执行精细操作。
GO-3 Preview 与 AGIBOT 的混合后训练系统 Genie Evolver 及其具身智能体框架 Genie Master 共同构成一个覆盖预训练、后训练和真实世界部署的一体化学习系统。
AGIBOT 将这一方法称为“全生命周期扩展”,旨在帮助机器人形成通用能力、通过交互打磨技能,并在真实世界工作中持续学习提升。
大语言模型在推理和知识型任务上取得了显著进展,但在物理世界中工作,仅靠理解指令远远不够。
抓取小物体、组装零部件等任务,要求具备预判环境变化、管理接触力并执行精确物理运动的能力。
对具身 AI 而言,挑战不只是扩大模型训练规模,而是将学习延伸到整个生命周期。机器人不能仅在预训练阶段发展能力,还必须在后训练交互中学习,并在部署后持续适应。
GO-3 Preview 正是围绕这一原则设计:让机器人不仅能学会如何执行任务,还能通过执行任务变得更强。
预训练扩展:构建可跨任务迁移的通用能力
设想一条简单指令:“拿起杯子。”这个物体可能是有把手的马克杯,也可能是光滑的玻璃杯;可能放在桌子中央,也可能被杂物包围。要应对这些变化,机器人不能只记住特定物体或固定动作,它需要能够跨任务、跨环境迁移的通用能力。
在预训练阶段,GO-3 Preview 通过其具身原生 WRAM 架构同时扩展数据和模型能力,以应对这一挑战。该方法旨在帮助机器人学习可迁移技能,并更快适应陌生情境。
WRAM 在统一架构内连接任务理解、未来状态预测和动作生成。CoAE、SVP 和 KASO 三项核心设计协同工作,帮助模型理解需要做什么、预判接下来可能发生什么,并生成完成任务所需的动作。
CoAE(面向控制的自编码器)提取专为机器人控制定制的视觉表征,保留物体位置、形状和空间关系的信息。通过将视觉感知与物理动作关联,它为预测未来状态和生成恰当运动提供了基础。
SVP基于当前观测和任务条件,在单步内生成对未来状态的完整预测。随后,动作生成模块学习如何从当前状态向预测结果推进。
通过将机器人的观测与可能的未来发展相关联,SVP帮助模型预判变化,而不是仅依赖即时的视觉输入。
KASO通过选择与训练期间实际执行动作更一致的未来预测,来应对物理环境中多种可能结果的挑战。
这些被选中的预测用于联合学习,帮助将未来状态预测与动作生成对齐,使模型能够学习产生物理一致结果的动作。
基于这三种机制,GO-3 Preview通过数据和模型两方面的发展来扩展学习规模。在数据方面,模型从异构来源中学习。人类第一人称视频提供了物体交互和任务执行的丰富示例,而机器人轨迹则建立了观测、动作及其物理结果之间的联系。
在模型方面,学习能力的提升帮助系统组织这些多样化经验,并将其转化为可跨不同任务应用的通用能力。目标不仅是学习更多示例,而是在遇到新情境时更好地利用这些经验。
GO-3 Preview从人类第一人称视频和机器人轨迹中学习,将物体交互和任务执行与动作及物理结果关联起来。
在预训练之后,GO-3 Preview在零样本和少样本设置下展示了任务适应能力。在零样本场景中,模型无需在物理机器人上进行任务特定的监督微调,即可将先前学到的能力应用于新任务。
这展示了其将通用技能迁移到不熟悉任务和环境的能力。对于更复杂的操作,GO-3 Preview可通过少样本学习进一步提升,利用少量演示来适应其能力。
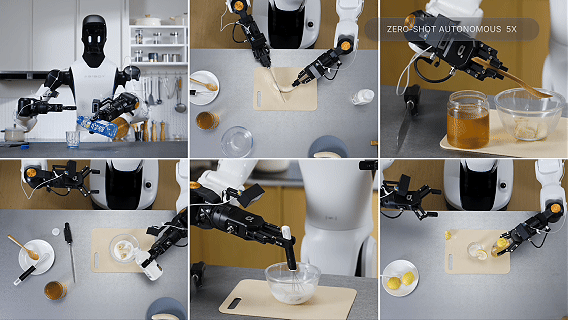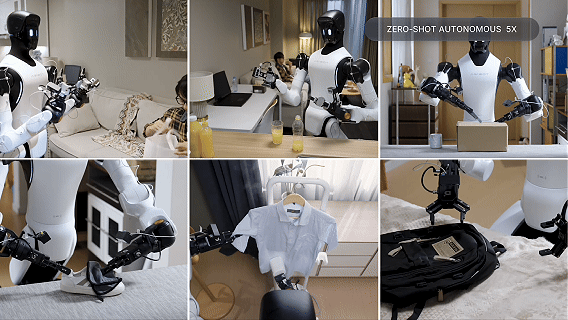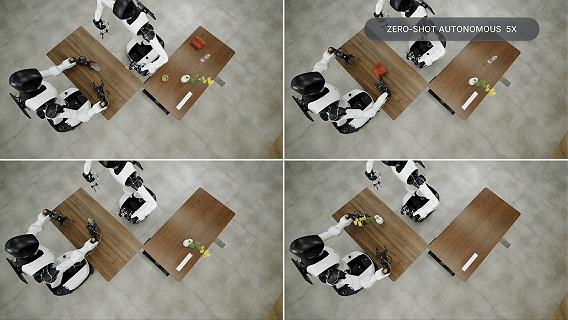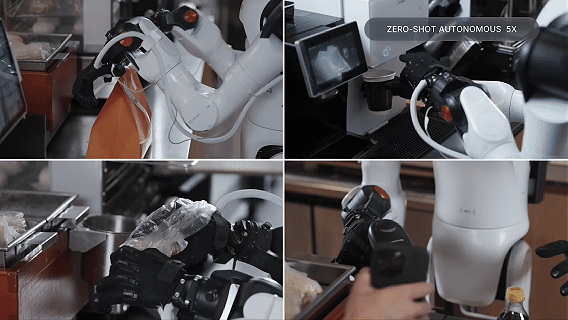
乐高组装提供了一个示例。该任务要求机器人识别各个组件、精确抓取、对齐位置并正确插入。
在有限的额外演示和微调下,模型可以学习这些精确操作技能,同时具身智能体将各个步骤协调为完整的组装流程。
这些示例共同展示了预训练如何建立通用基础,既支持直接的任务迁移,也支持进一步的适应。
后训练扩展:通过物理与虚拟交互实现提升
仅有通用能力不足以让机器人可靠地执行每一项复杂任务。正如人们通过反复练习来精进技能,机器人也需要机会去尝试、接收反馈并改进其动作策略。
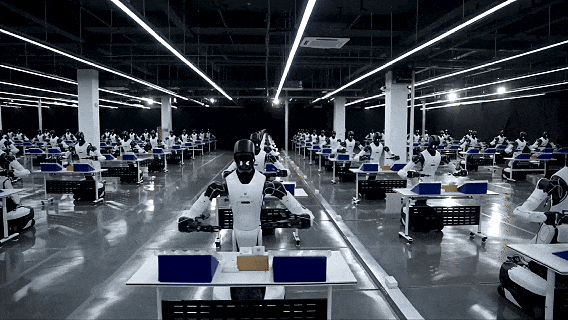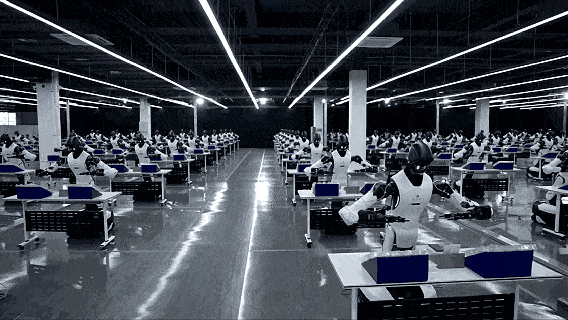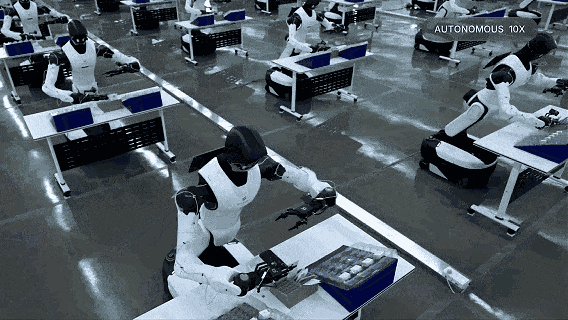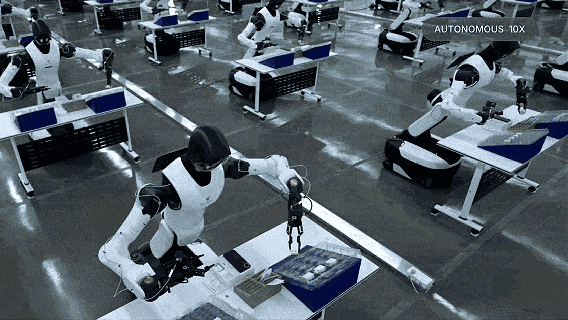
在 GO-3 Preview 的后训练阶段,AGIBOT 开发了 Genie Evolver,这是一个分布式混合环境训练系统,将 100 台实体机器人集群与物理仿真和世界模型相结合。
通过扩大交互的规模和多样性,Genie Evolver 使机器人能够从物理执行和虚拟探索中学习,并通过反馈不断优化其动作策略。该系统汇集了三种互补的学习环境。
实体机器人:从集体经验中学习
在真实环境中,Genie Evolver 使用 CEL(集体经验学习)来汇总多台机器人的执行经验。成功的轨迹提供了有效动作的示例,而失败尝试的上下文则有助于识别需要改进的地方。
通过检索相关的成功经验并更新共享策略,CEL 让单台机器人学到的经验惠及整个机器人集群。该系统无需每台机器人独立学习所有内容,而是使集体经验可复用。
物理仿真:扩展交互范围
物理仿真提供了受控环境,机器人可以在不同条件下进行练习和评估。
这些环境扩展了可用于训练的物理交互和场景范围,同时允许在一致条件下重复实验。这使得探索替代策略并提高在更广泛情境下的鲁棒性成为可能。
物理仿真帮助机器人在多样化场景中练习和改进。
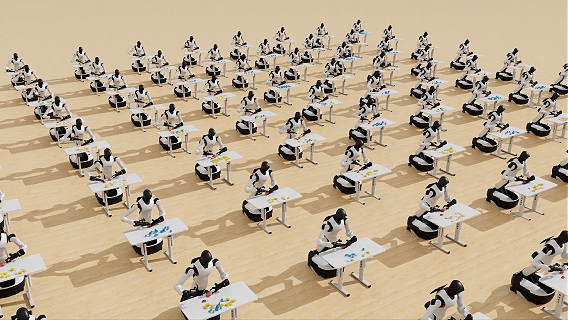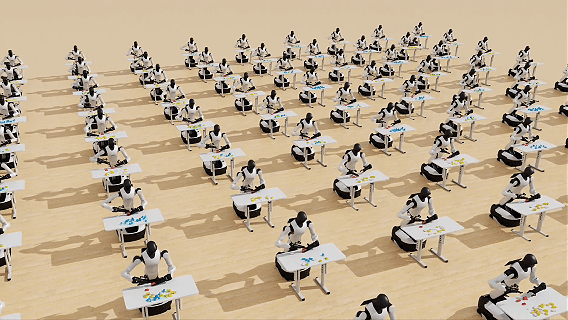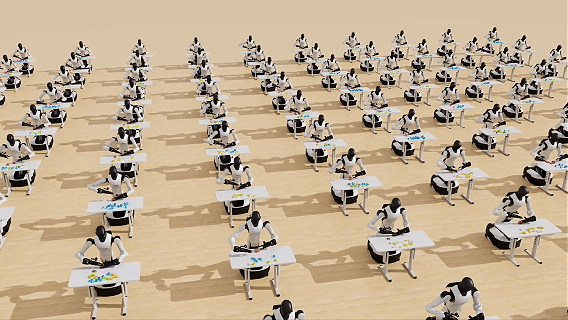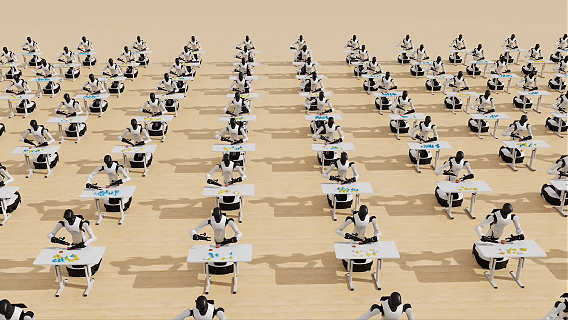
世界模型:探索多种可能的未来
世界模型使系统能够通过探索替代结果,从每次真实世界经验中学习更多。
Genie Evolver 不是将一次交互视为单一的动作序列,而是可以重新审视关键决策点,在世界模型中测试不同的可能动作,并预测和比较其结果。这些探索产生的反馈随后用于优化动作策略,之后可在实体机器人上进行测试。
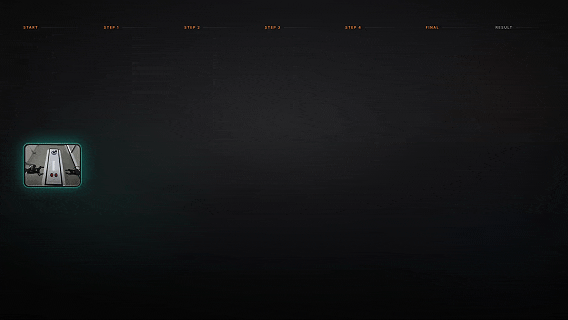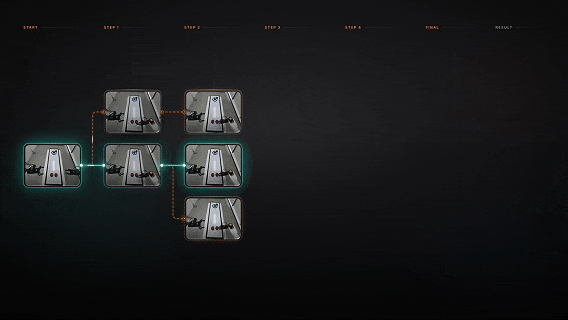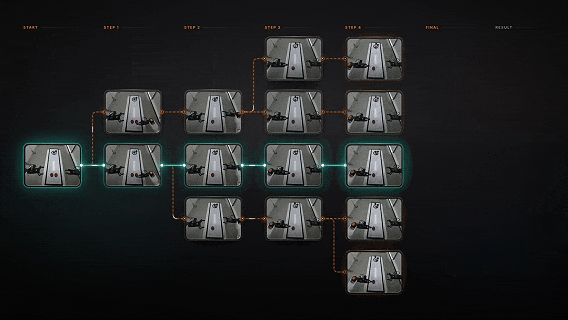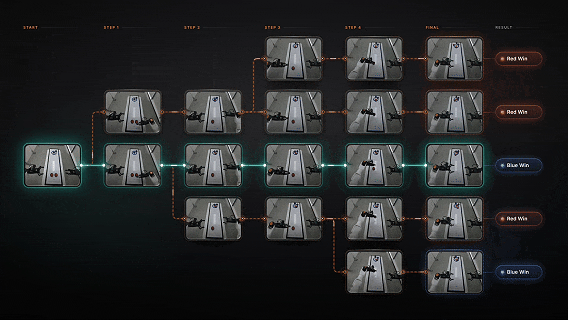
这些环境共同构成了一个持续改进的过程,真实世界执行、仿真和未来状态探索相互强化。AGIBOT 通过若干需要精度、适应性和快速决策的操作任务展示了这一方法。
在桌面冰壶中,机器人必须控制每次投掷的力度和角度。力度过小可能无法推动对手的冰壶,而力度过大则可能将机器人自己的冰壶送出得分区。成功取决于在考虑冰壶位置的同时取得恰当平衡。
据 AGIBOT 称,在结合真实世界交互和世界模型学习仅数小时的练习后,该机器人的胜率便超过了普通人类玩家。
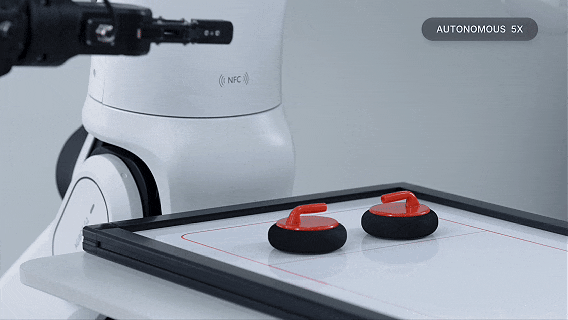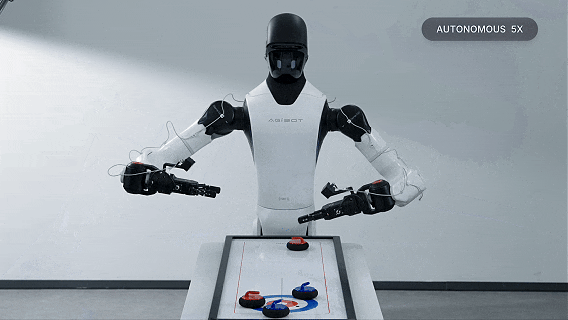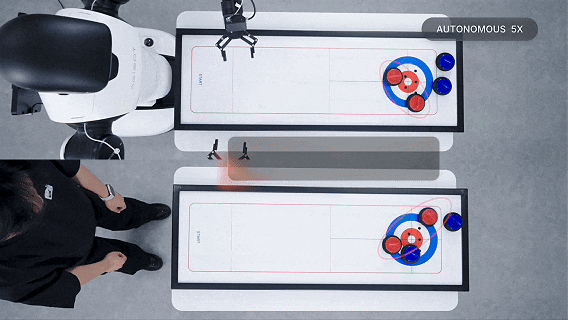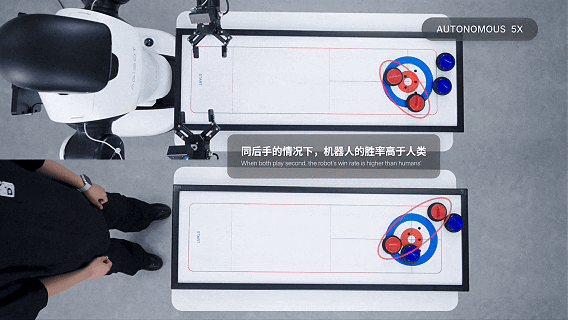
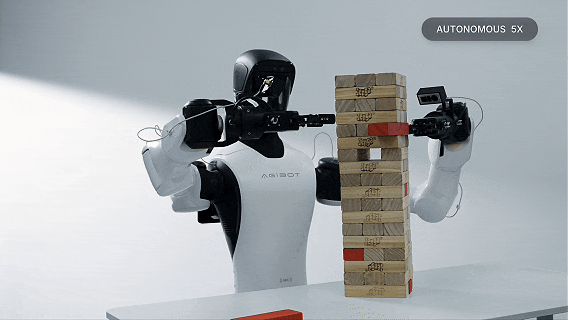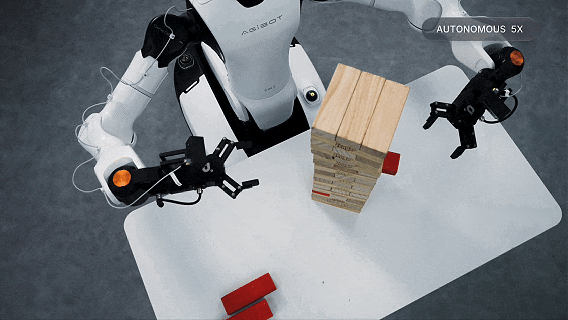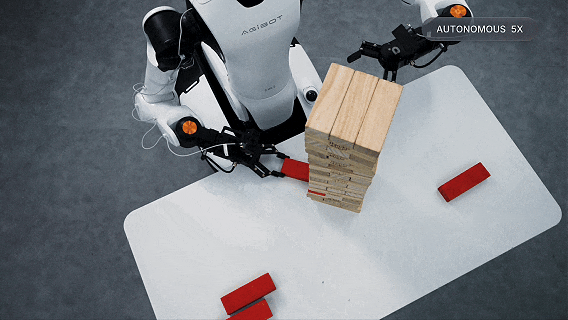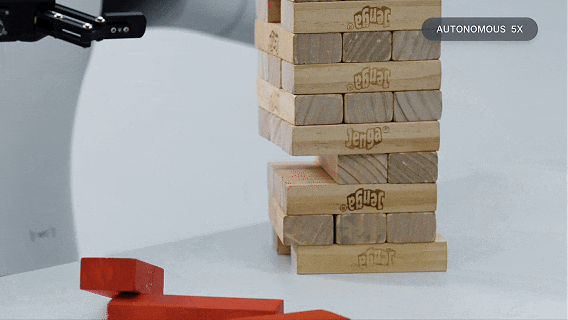
积木抽取带来了另一种挑战:每一次成功的动作都会改变下一步的条件。当一块红色积木被移走后,其余积木的位置和朝向可能发生偏移。这些变化会影响后续决策,使得通过固定的动作序列完成任务变得困难。
借助积累的经验,机器人可以在每次动作后重新评估堆叠状态,调整策略,并继续移除目标积木,直至任务完成。
将球投入移动中的篮筐是一项更具动态性的挑战。与静止目标不同,移动的篮筐留给机器人观察、预测和反应的时间更少。机器人必须快速识别篮筐的位置,同时实时调整投掷的力度和角度。
对快速变化条件的准确预测同样重要,这使机器人能够协调自身动作并在恰当时机释放球。这些演示共同展示了 GO-3 Preview 如何通过反复交互、反馈和策略优化来提升其操作能力。
部署后扩展:通过真实世界工作学习与改进
即使经过大量预训练和后训练,机器人在部署到真实环境后仍不可避免地会遇到从未见过的情况。传统上,解决此类问题往往需要人类工程师修改代码、收集额外数据或手动调整机器人行为。
这限制了部署后能力提升的速度。AGIBOT 的方法是将学习延伸到部署阶段本身,使机器人在执行真实任务的同时不断改进。
通过其具身智能体框架 Genie Master,AGIBOT 将规划、执行、反馈和经验留存连接起来,帮助机器人适应新挑战并持续发展其能力。Genie Master 引入了 EEP(具身执行协议),该协议标准化了四类接口:能力、指导、反馈和连续性。
这些接口使具身智能体能够识别哪些机器人能力可用、确定任务应如何执行、评估结果是否满足预期要求,并跟踪尚未完成的工作。
通过连接这些功能,Genie Master 帮助机器人协调任务执行、识别失败、从异常中恢复并留存有用的操作经验。
关键在于,这些经验可以通过两条互补的学习路径促进未来的改进。第一条将操作经验转化为长期记忆。在任务规划和执行过程中,系统会记录成功和失败的尝试,捕捉可为后续决策提供参考的经验教训。
在每天的操作结束时,模型会将这些经验中可复用的知识整合到长期记忆中。
当出现类似任务或情境时,智能体可以检索相关的过往经验来指导任务规划、改进决策并支持从失败中恢复。这使得在一个任务中学到的经验能够成为未来操作的有用知识。
第二条路径将执行经验转化为改进的动作策略。当智能体协助执行、在必要时接管并支持从失败中恢复时,系统会生成轨迹和反馈,记录问题、调整与结果。
这些记录可被处理并用于机器人动作策略的进一步训练。随着时间推移,有效的调整可被纳入模型参数,将实践经验转化为可在后续任务中复用的能力。
这形成了一个反馈闭环:部署不仅让现有技能发挥作用,还产生新的学习机会。
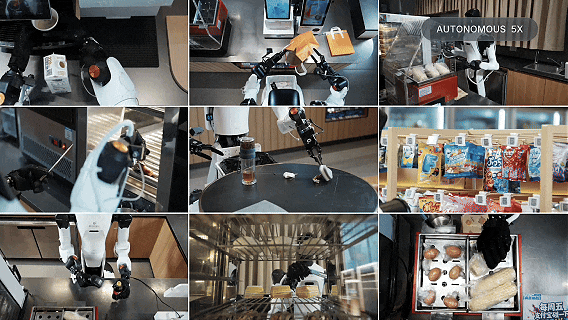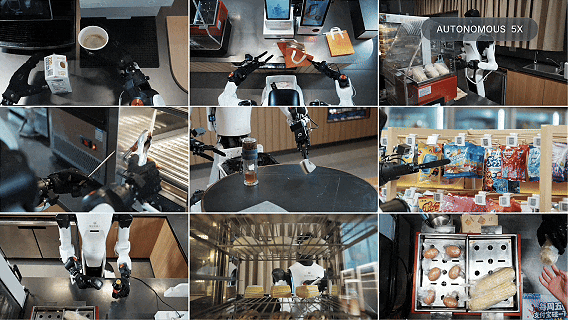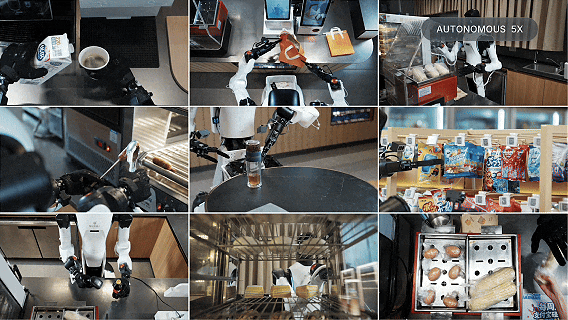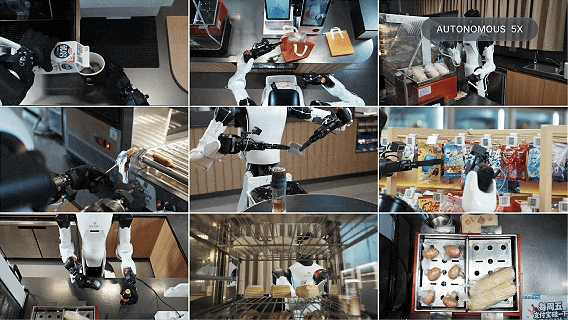
AGIBOT 在真实便利店环境中使用其 Genie G2 机器人展示了这一方法。在 Genie Master 的驱动下,该机器人能够识别任务失败的原因、调整策略,并在执行操作任务时积累经验。
据 AGIBOT 称,该机器人在多项需要精确操作的复杂任务中持续改进,且不依赖人类演示或手动调参。
该公司将此次演示描述为无人在环的自主改进示例,机器人从自身操作经验中学习,而非完全依赖外部干预。
AGIBOT 还将其描述为在真实商业环境中对 Physical RSI(物理世界递归自我改进)的演示,将自我改进的概念从仿真和实验室环境扩展到现实场景。
这一方法的意义在于将真实世界执行与持续学习连接起来。Genie Master 不把部署视为模型开发的最终阶段,而是让操作经验成为持续改进的资源。
从 GO-1 到 GO-3:将扩展延伸至完整学习生命周期
从 GO-1 引入的 ViLLA 框架到 GO-2 首创的动作思维链方法,AGIBOT 持续扩展其具身智能模型的能力。
GO-3 Preview 代表这一发展的下一步,将扩展从预训练延伸至后训练和部署后的学习。
其在 RoboDojo、RoboTwin 和 RoboColiseum 上的第一名排名,以及任务迁移、复杂操作和真实世界适应的演示,凸显了这一全生命周期方法的潜力。
GO-3 Preview、Genie Evolver 和 Genie Master 并非依赖单一阶段的改进,而是连接三个关键过程:通过预训练发展通用能力、通过物理与虚拟交互优化动作策略,以及将真实世界操作经验转化为持续学习。
随着数据、反馈和经验形成持续循环,该系统旨在帮助机器人随时间扩展其能力。
对 AGIBOT 而言,全生命周期扩展代表了一条从获取技能到应用、复用和改进技能的路径——使机器人能够将所学转化为实际表现,并将每一项真实世界任务变为提升能力的机会。
如需了解更多信息,请访问 AGIBOT.com 并关注 AGIBOT:
- X:https://x.com/AGIBOTofficial
- LinkedIn:https://www.linkedin.com/company/agibot/
- YouTube:https://www.youtube.com/@AGIBOTofficial
- Instagram:https://www.instagram.com/agibotofficial/
- TikTok:https://www.tiktok.com/@agibotofficial
- Facebook:https://www.facebook.com/AGIBOTofficial/
关于 AGIBOT
AGIBOT 是全球通用人工智能机器人行业的先驱,其核心技术聚焦于具身智能。AGIBOT 的“三智合一”架构将运动智能、交互智能与操作智能整合为一个统一的具身系统。
其产品组合涵盖人形机器人、四足机器人、灵巧系统以及商用清洁解决方案。2026 年 9 月,AGIBOT 宣布其第 20,000 台机器人已下线。
主图:GO-3 Preview 从人类第一人称视频和机器人轨迹中学习,将物体交互与任务执行同动作及物理结果关联起来。

来源:Robotics & Automation News · roboticsandautomationnews.com